
Scientific Trace:让自进化实验室的判断有据可查
TECHNICAL REPORT · SCIENTIFIC TRACE
科研 Agent 已经能够检索文献、调用工具并生成研究建议。但面对一条具体结论,生物学家仍需要追问:它基于什么输入和条件,经过哪些计算或实验验证?这些问题决定了一条建议能否进入下一步实验,也决定了结果不符合预期时,能否找到需要重新检查的环节。本文介绍 SE-Fab 的 Scientific Trace:一项支持生物学家与 Agent 追溯执行证据、复核关键判断的功能,让自进化实验室的判断有据可查。
Scientific Trace 将关键判断与输入数据、工具调用、证据产物及人工复核记录关联起来,帮助生物学家和 Agent 沿着结论查找依据、检查适用条件并识别证据缺口。成功结果连同适用条件保存,失败过程留下排查线索,判断修正保留对应依据。相关记录可随任务归档与导出,供不同生物学家与 Agent 核查、交接和整理经验,为后续实验设计、评审标准与研究策略的改进提供依据。
本文从一个聚合酶突变案例出发,说明科研判断为什么需要关联证据与适用条件;随后介绍 Scientific Trace 的记录机制与复核流程,并通过一次真实的酶筛选任务和外部模型读取证据包的演示,展示如何追查执行过程、核对结论依据,以及这些记录能够支持哪些核验。
00 / 真实科研中的问题
看一眼 vs 证据链
看一份凝胶电泳图,对一位资深生物学家而言不过是几秒钟的事:根据条带位置初步判断是否出现预期大小的扩增产物,并从异常条带中发现需要进一步排查的线索,如非特异扩增或引物二聚体。这个“看一眼、下判断”的过程,早已通过数千次实验失败与实验台经验,内化为生物学家的物理世界模型。
当模型参与更复杂的分子设计任务时,这类判断依据更需要被明确记录。设想这样的场景:用户输入一段耐热 DNA 聚合酶序列,模型很快给出一份设计建议:“推荐突变位点 T375A,结合自由能变化 -2.3 kcal/mol,参考文献 PMID: 31245678”。
这段话在屏幕上显得极为工整、自信。然而在真实的生命科学研发中,生物学家需要追查几个关键问题:
- 这个残基编号在多序列比对(MSA)里有没有偏移?
- 自由能参数是调用 Rosetta 实际计算出来的,还是模型凭语言概率编造的?
- 引用的文献在 PubMed 里究竟存不存在?
- 计算使用的是哪一版序列和结构?中途有没有数据截断?
在纯软件世界里,许多失败的调用可以较快重试;但在生命科学实验室里,一次质粒构建、引物合成、细胞表达与酶活测试需要数天甚至数周,一盒高保真酶和试剂消耗动辄数千上万元。实验投入之前,生物学家需要看清推荐依据、适用条件和验证路径。让这些信息随方案一同交付,才能把资源投入到有依据的下一步探索。
资深生物学家的快速判断背后有可以追问的经验与实验依据;Agent 的建议同样需要可追问、可核查的依据。可核查的输入、实际工具调用、可按哈希校验的产物快照与独立复核,让生物学家能够检查判断的依据和适用范围。
案例:聚合酶突变建议如何经受证据检验
展开案例:同一个突变,换一个背景,结果为什么不同
为测序应用改造一款 DNA 聚合酶时,生物学家需要同时兼顾修饰核苷酸的掺入能力、对四种底物的表现是否均衡,以及与 DNA 的相互作用是否适合测序流程。本文将所考察的单个位点改动记为 A 突变,以工程化亲本 BP0 为活性比较基准。A 突变所涉及的位点值得考察:归档的结构分析显示,相关位点靠近 DNA 接触区域,位于催化口袋之外。这一结构线索帮助生物学家确定了值得实验检验的改造方向。
如果只根据这类结构信息,大模型很容易给出一个听起来合理的建议:“优先改造外围 DNA 接触位点,在调整 DNA 相互作用的同时保留催化功能。”然而,活性测定揭示了这句话遗漏的条件:A 突变单独加入 BP0 时,保留了约 97.3% 的相对活性;当它加入已经提高活性的组合突变后,活性却从 BP0 的约 2.41 倍降至 1.89 倍,相对于该组合下降约 21.6%。在一个背景下影响较小的突变,换到另一个背景中,就可能付出明显的活性代价。这组结果说明,突变效果需要结合具体的序列背景与检测条件理解,结构线索和实验结果应当放在同一条判断链上。
面对这样的建议,生物学家需要沿着证据继续追问:
- 位点编号对应的是哪一版序列和结构?当前设计是否保留了 BP0 已有的工程化背景?“靠近 DNA、位于催化口袋之外”的判断来自哪个模型、哪些距离计算?原始分析结果能否找到?
- “保留 97.3% 活性”是在什么突变背景和检测条件下测得的?新任务需要评价的是修饰核苷酸掺入活性,还是 DNA 滞留?现有活性结果能否直接用于评价新的组合?
- 新结果出现后,原来的建议如何调整?哪些判断仍然成立,哪些需要补充实验?
让推荐、证据、适用条件和待验证问题一起进入下一轮实验,才能看清一次设计为什么成立,又应该如何调整。
这也是 SE-Fab 建立执行证据链的原因:将输入序列、结构分析、工具输出和变体身份关联记录起来,明确区分事实、推断与建议。当新证据改变判断时,保留原始记录,并说明为什么修正、还有哪些疑问、下一步需要验证什么。这样,生物学家既能追查一个推荐如何产生,也能理解它为何被保留、调整或否决,让每一轮实验积累的证据真正用于下一轮设计。
01 / 角色协作:生物学家与 AI 工程师的共同要求
Agent 走向实验台面,首先需要回应两类角色对交付的不同关注点:
生物学家: “我不在乎你在屏幕背后调用了多大参数的模型,也不在乎生成的文字多么通顺。我只要知道:这套方案哪一步真实算过、哪一步是猜的?底层数据被截断过没有?下周如果在台面上跑崩了,我能不能顺着记录查出究竟是哪一步出了问题?”
AI 工程师: “生命科学的任务链路极长,往往涉及几十个专业生信工具与外部数据库,模型每一步调用都伴随着随机性。我希望像在软件系统里看调用链路一样,检查 Agent 的判断是否有据可查;我希望每一次结论都有确凿的证据指针,而不是每当结果不理想,就让整个 AI 系统背上‘模型幻觉’的黑锅。”
Scientific Trace 要同时回应这两种诉求:让 AI 工程师交付带有可核查证据的推论,让生物学家能够像审查同行论文一样审查 Agent 的执行过程,并让复核意见成为双方推进下一步任务的共同依据。
自动化的终点不是替人类按下回车键,而是把一次不确定的概率生成,转化为可发现、可理解、可验证、可复查、可复用的科学证据。
02 / 背景:自进化实验室如何关联判断依据与执行记录
科研任务中的判断主要来自模型与软件计算、实验与设备执行,以及经验与专家判断。Scientific Trace 将这些判断与支撑证据关联起来:
- 模型与软件计算:保存输入版本、计算条件、工具调用与产物,沿着结论查找依据(已建立)。
- 实验与设备执行:记录实验提交前的设计依据,并关联后续运行与测量反馈(设备记录接入正在推进)。
- 经验与专家判断:保留生物学家和专家的关键抉择、Agent 的路线选择与 Reviewer 复核意见,交代谁依据什么改变了方案(已建立)。
SE-Fab 建设自己的 Trace,是为了将证据追溯落实到具体科研任务:围绕输入版本、计算与实验条件、判断依据和人机决策,把研究中的选择与执行记录连成可查阅、可复核的过程档案。已有的可观测、溯源和实验编排研究提供了基础,我们据此组织 SE-Fab 的任务流程与证据。
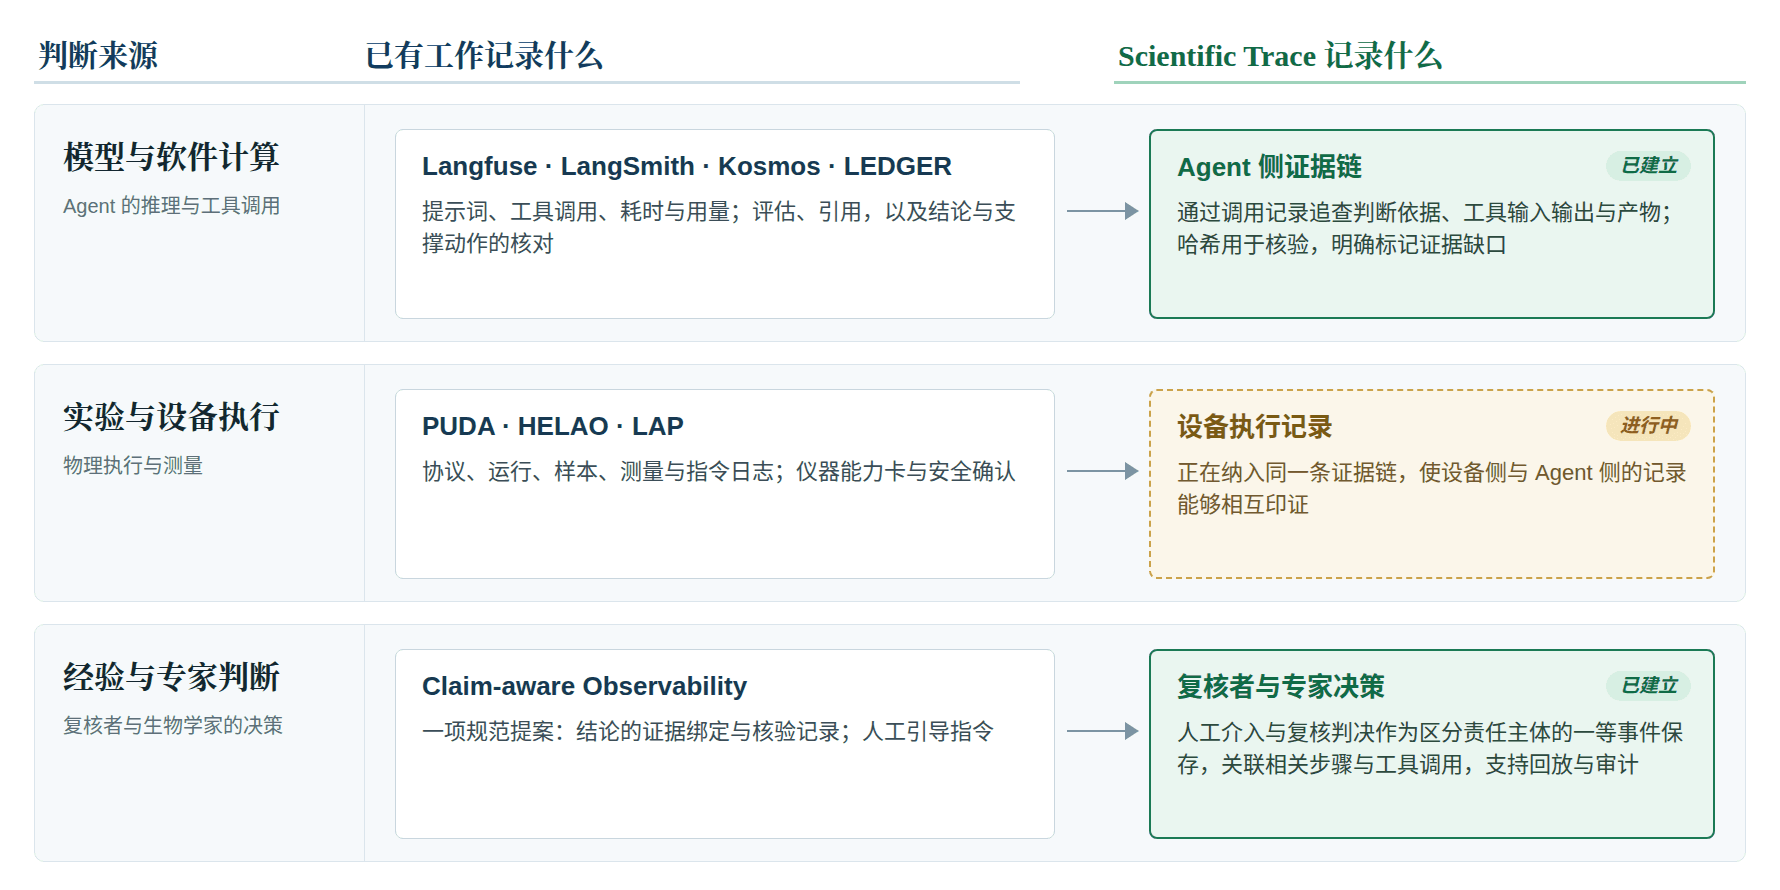
三类决定的已有记录方式,以及 Scientific Trace 记录的范围
相关研究与设计取舍
| 判断来源 | 参考做法 | 已有工作的着力点 | Scientific Trace 的设计与科研价值 |
|---|---|---|---|
| 模型与软件计算 | Langfuse、LangSmith[1][2];Kosmos、LEDGER[3][4] | 记录调用过程、性能与用量,并将报告结论关联到代码、文献、支撑动作或产物,便于追查结果来源 | 按结论组织计算条件与证据:将输入版本、比对阈值、参考数据库和工具环境与调用记录一同归档,通过步骤、调用编号与证据引用关联判断依据;产物以内容哈希保存。生物学家能直接定位判断所依赖的条件,据此决定结果是否适用于当前任务、哪些环节需要重新验证(已建立) |
| 实验与设备执行 | PUDA、HELAO、LAP[5][6][7];SAMPLE[8] | 围绕协议、运行、样本与测量组织实验执行和数据溯源,支持设备协作;其中部分包含自主规划与实验反馈 | 贯通实验选择依据与执行反馈:在实验提交前记录 Agent 的设计判断及其工具、文献依据,再以运行编号、时间信息和产物关联设备记录。一次异常可以沿着设计、参数与执行条件追查,帮助区分需要修改方案还是排查执行偏差(设备接入进行中) |
| 经验与专家判断 | Claim-aware Observability、PROV-AGENT[9][10] | 将科学结论、证据绑定与人的调整纳入观测或溯源模型,也覆盖仪器文件、操作员批准等可审计对象 | 把决策依据留给下一位协作者:将生物学家介入、模型选择和 Reviewer 判决记录为区分责任主体的一等事件,与相关步骤和证据关联。既能回放、追溯责任主体,也能让后续生物学家与 Agent 理解方案为什么被接受、修改或否决,为经验提炼与评审标准改进提供依据(已建立) |
模型与软件计算:从结果来源追溯到判断条件
调用链与结论溯源已经让提示词、工具调用、代码和文献引用变得可追查,上述平台与系统分别提供了调用记录和结论溯源的基础。OpenTelemetry GenAI[11] 与 Workflow Run RO-Crate[12] 进一步提供追踪语义和工作流运行记录的交换方式,使不同系统能够组织和交换执行记录。
在 SE-Fab 的生命科学任务中,我们把结果成立的计算条件随记录保留。 例如,一次比对返回了候选序列,生物学家需要知道用的是哪一版输入、是否发生截断、阈值如何设置、参考数据库是否与当前研究一致。这些条件决定了候选为何被选中,也决定了数据库或任务背景变化后,这个结果还能怎样使用。
Scientific Trace 因此按“结论—条件—证据”组织记录:计算条件随调用保存,判断依据通过步骤、调用编号和证据引用串联,产物按内容哈希保存;Reviewer 沿着这些关联复核证据的支持程度。生物学家得到的不只是一个结果出处,还包括判断它是否适用、如何复核和何时需要重验的依据。 事件随任务持续写入,后续解释与修改也留在同一份档案中,便于回查原判断与新判断各自依据了什么。
实验与设备执行:把“为什么做”与“实际做了什么”对应起来
设备与实验一侧的已有工作,重点是组织可靠的仪器调用、实验编排与运行数据溯源,相关实践包括 PUDA、HELAO、LAP 和 SAMPLE[5][6][7][8]。这些工作让协议、运行、样本与结果之间的联系能够被记录,其中部分还包含自主规划和实验反馈。
在 SE-Fab 中,这条链路还要容纳来自生信工具、文献和生物学家判断的设计依据。 例如,为什么优先测试这个突变组合,哪次计算支持了它,生物学家为什么调整反应条件?这些问题需要把实验提交前的选择依据与后续执行结果对应起来,才能看清一次失败应该推动设计修改,还是先排查样本和执行条件。
Scientific Trace 在提交实验之前就记录 Agent 的设计判断、工具结果与生物学家意见,形成可回查的依据链。接入设备记录时,以运行编号、时间信息和相关产物将执行反馈与这条依据链关联。这样的设计把实验选择、参数取舍和执行反馈放在一起复核,使一次异常留下可用于下一轮排查与设计的线索。
经验与专家判断:让决策理由能够被交接和复用
Claim-aware Observability 与 PROV-AGENT[9][10] 已将结论、证据关系和人的调整纳入通用观测或溯源模型,为人机协作留下记录。科研任务进一步关心的是:一项调整针对哪个问题,依据了什么证据,为什么原方案被接受、修改或否决。
Scientific Trace 将生物学家的介入、模型的路线取舍与 Reviewer 的复核判决,作为区分责任主体的一等事件保存,与相关步骤、工具调用和证据关联;生成与复核双方的意见都接受证据约束。一次推荐的依据、生物学家的调整理由和 Reviewer 的质疑因此可以在同一份任务档案中对照查看,而不是散落在不同对话里。
保留这些理由,是为了让后续协作者理解已有选择,并判断哪些经验适合新的任务。 独立 Reviewer 的意见随证据包导出,生物学家与新的 Agent 可以据此继续核查、提炼经验和调整评审标准,让人的判断与模型的探索成为可持续积累的研究资产。
我们按科研判断组织记录,让生物学家既能查到任务如何执行,也能核对结论的依据和适用条件。
03 / 设计哲学
Scientific Trace 按四个要求组织任务记录,帮助生物学家核对执行、复核判断,并在后续研究中继续使用这些记录:
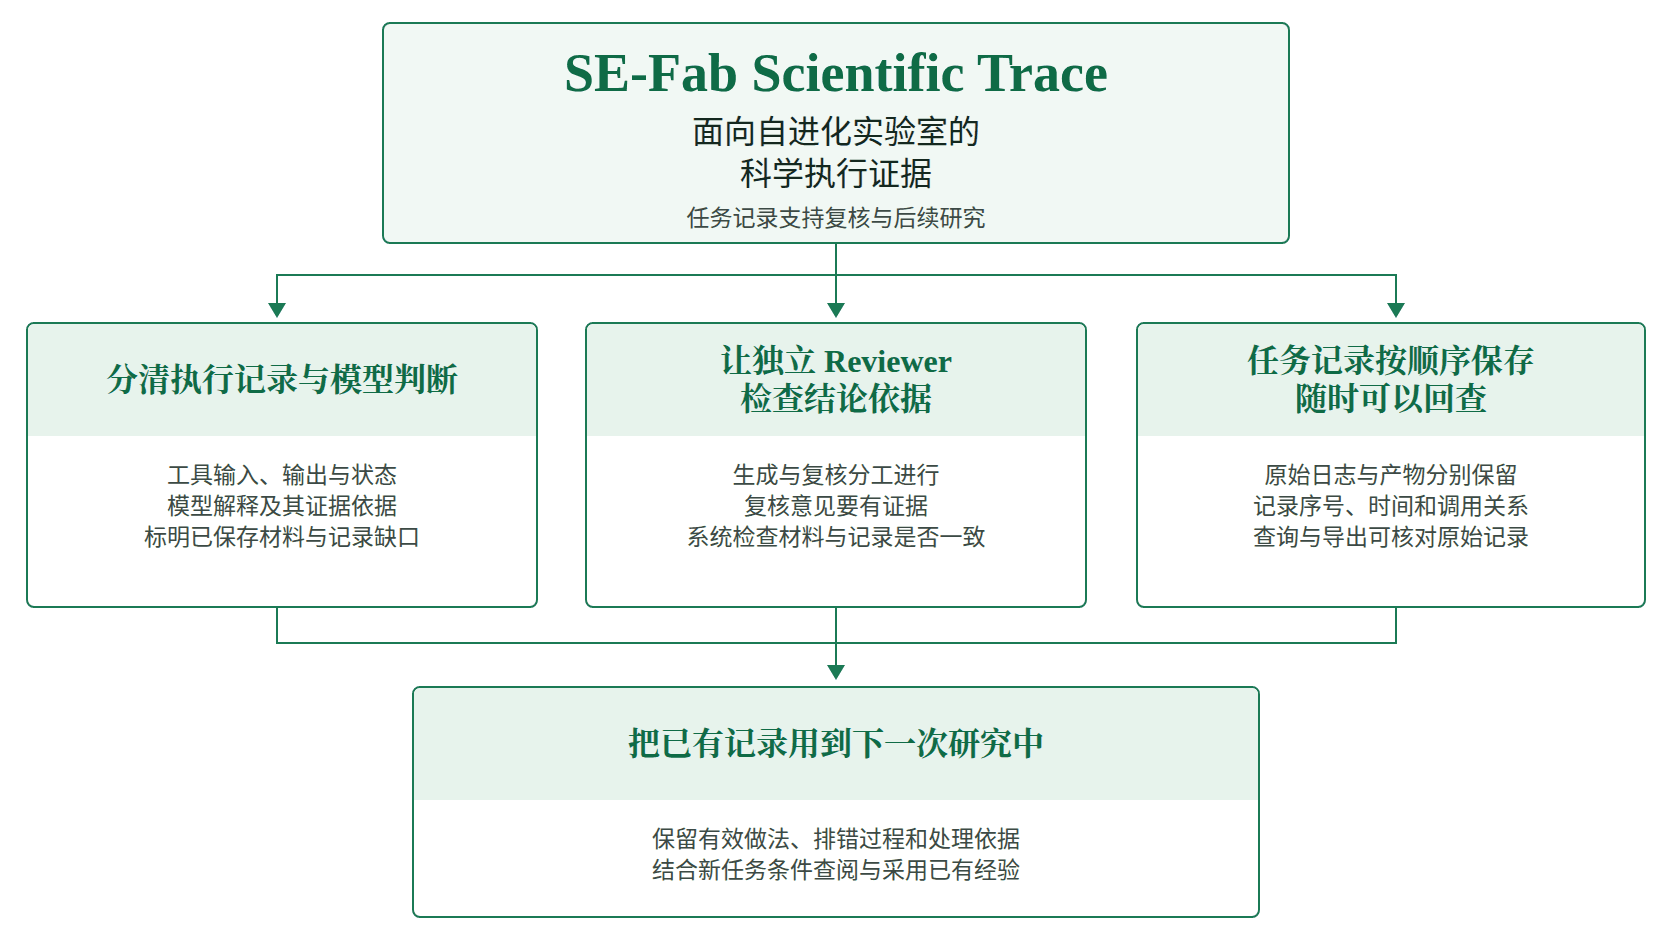
分清执行记录与模型判断
工具实际接收了什么、返回了什么,与模型如何解释结果,应当分开记录。Scientific Trace 同时保留这两类信息,生物学家可以把判断与实际执行情况对照查看。
- 执行事实(Facts) 保存工具实际接收的输入、返回的输出、运行状态与耗时,并记录产物的内容哈希。
- 科学判断(Judgments) 保存模型对结果的解释、提出的假设,以及支持这些判断的文献和产物,供 Reviewer 复核。
- 判断发生变化时,原始执行记录仍然保留;材料是否已保存、哪些记录缺失,也会明确标出,方便后续核查。
让独立 Reviewer 检查结论依据
提出方案与复核证据分别由不同角色负责,让结论经过一次独立检查。
- 主 Agent 与子代理 负责规划、推进任务和处理具体计算、文献阅读等工作。
- 独立 Reviewer 检查证据是否支持结论,说明发现了什么问题、依据是什么;系统自动检查记录结构和材料完整性。复核意见随任务保存,重要分歧由生物学家处理。
- 生成与复核都要说明依据。Agent 保留判断理由,Reviewer 需要说明问题依据,对判为失败的问题提供对应的产物或调用编号。文件是否存在等可直接核对的问题,会被写成结构化事实断言,再与已保存记录核对;如果质疑与记录冲突,系统会纠正对应问题的判定,并保留纠正依据。
任务记录按顺序保存,随时可以回查
一次任务经过了哪些步骤、每一步留下了什么结果,都应能从原始记录中查到。Scientific Trace 按顺序保存任务过程,并保留记录与产物的对应关系。
- 每个任务的过程记录依次追加保存;原始产物按内容哈希单独保存,记录中保留其引用与保存状态。
- 记录带有序号、时间戳和调用关系,方便还原执行顺序;写入时控制并发,避免序号冲突。
- 查询索引根据原始日志生成,可以重新构建。导出时保留原始事件记录与已保存产物,并按证据清单核对哈希,让查阅和交接有原始记录可核对。
把已有记录用到下一次研究中
Scientific Trace 将任务过程与复核意见保存在可追查的档案中,保留有效做法、排错过程和处理依据。生物学家与 Agent 可以回查一个选择如何产生、一个问题如何解决,再结合当前任务条件判断哪些经验适用。
配合 Agent 的记忆机制,相关背景与已有记录可以进入新的任务上下文,帮助后续任务接续研究,并为调整实验设计与评审标准提供依据。
04 / 核心设计:从意图到证据的任务链路
Scientific Trace 把一次任务的输入、工具调用、产物与复核记录组织为一个可整体导出、可脱机核验的证据包(Evidence Bundle)。
交互流程:从意图到证据的七个环节
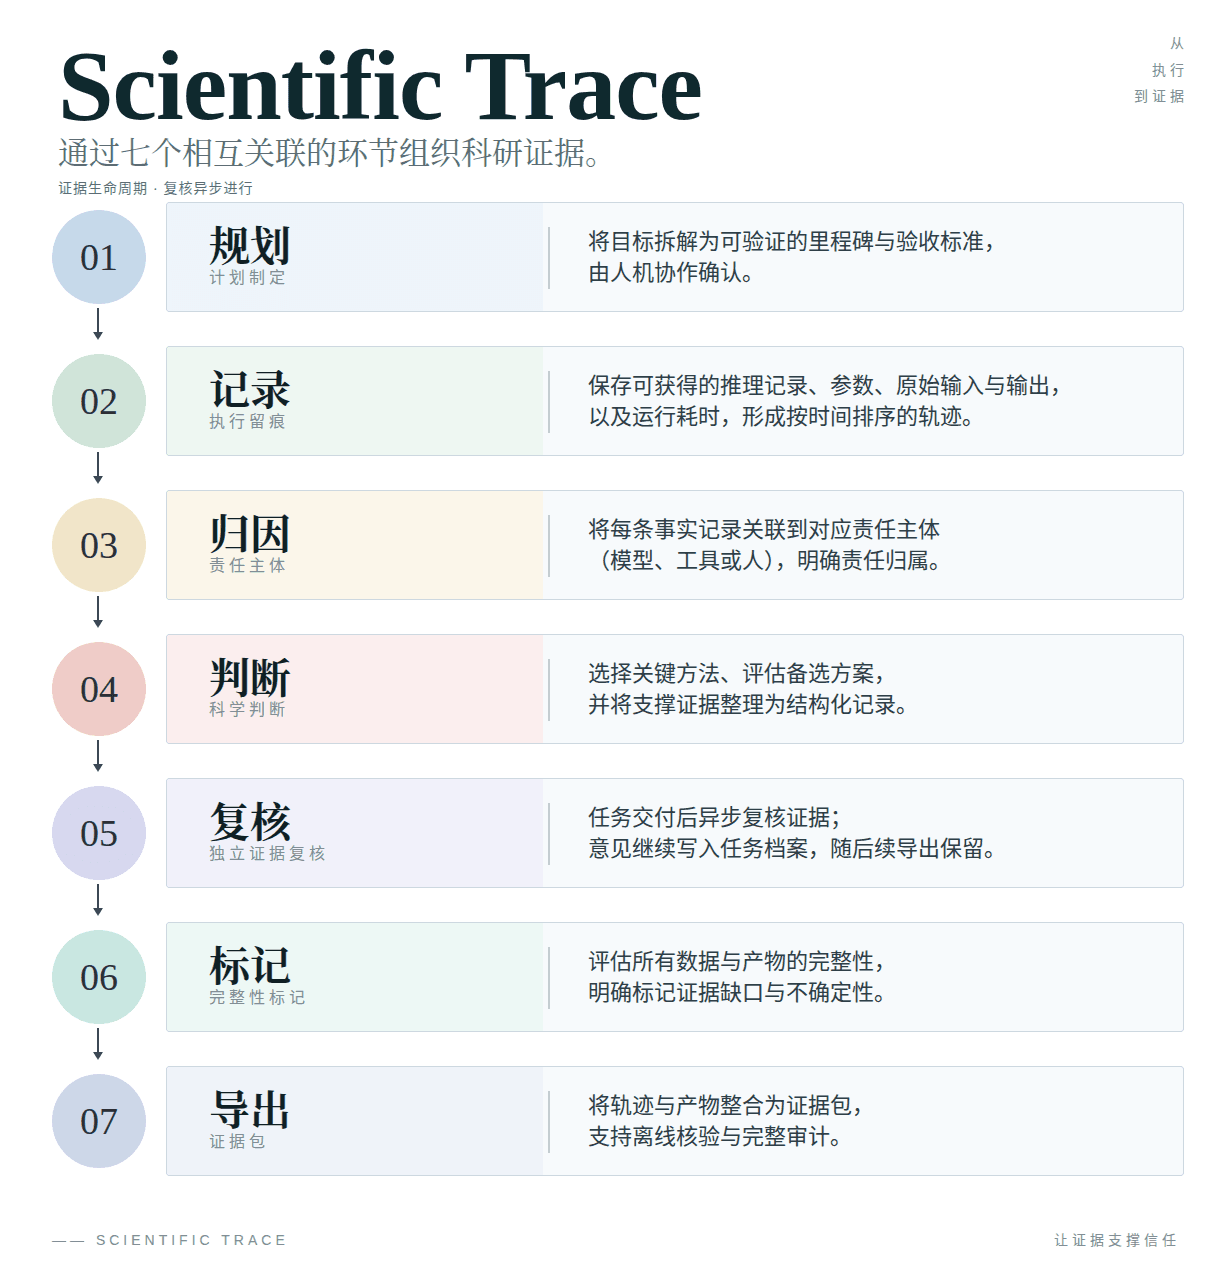
七个环节将规划、记录、归因、判断、复核、完整性标记和导出组织在同一条证据链上。其中,ATTRIBUTE(归因) 明确步骤与决策的责任主体,REVIEW(复核) 检查结论与证据的支持关系。Reviewer 在任务交付后异步复核,意见继续写入任务档案,供生物学家查阅并随后续导出保留。生物学家既能看清任务怎样推进,也能追查结果的依据与复核意见。
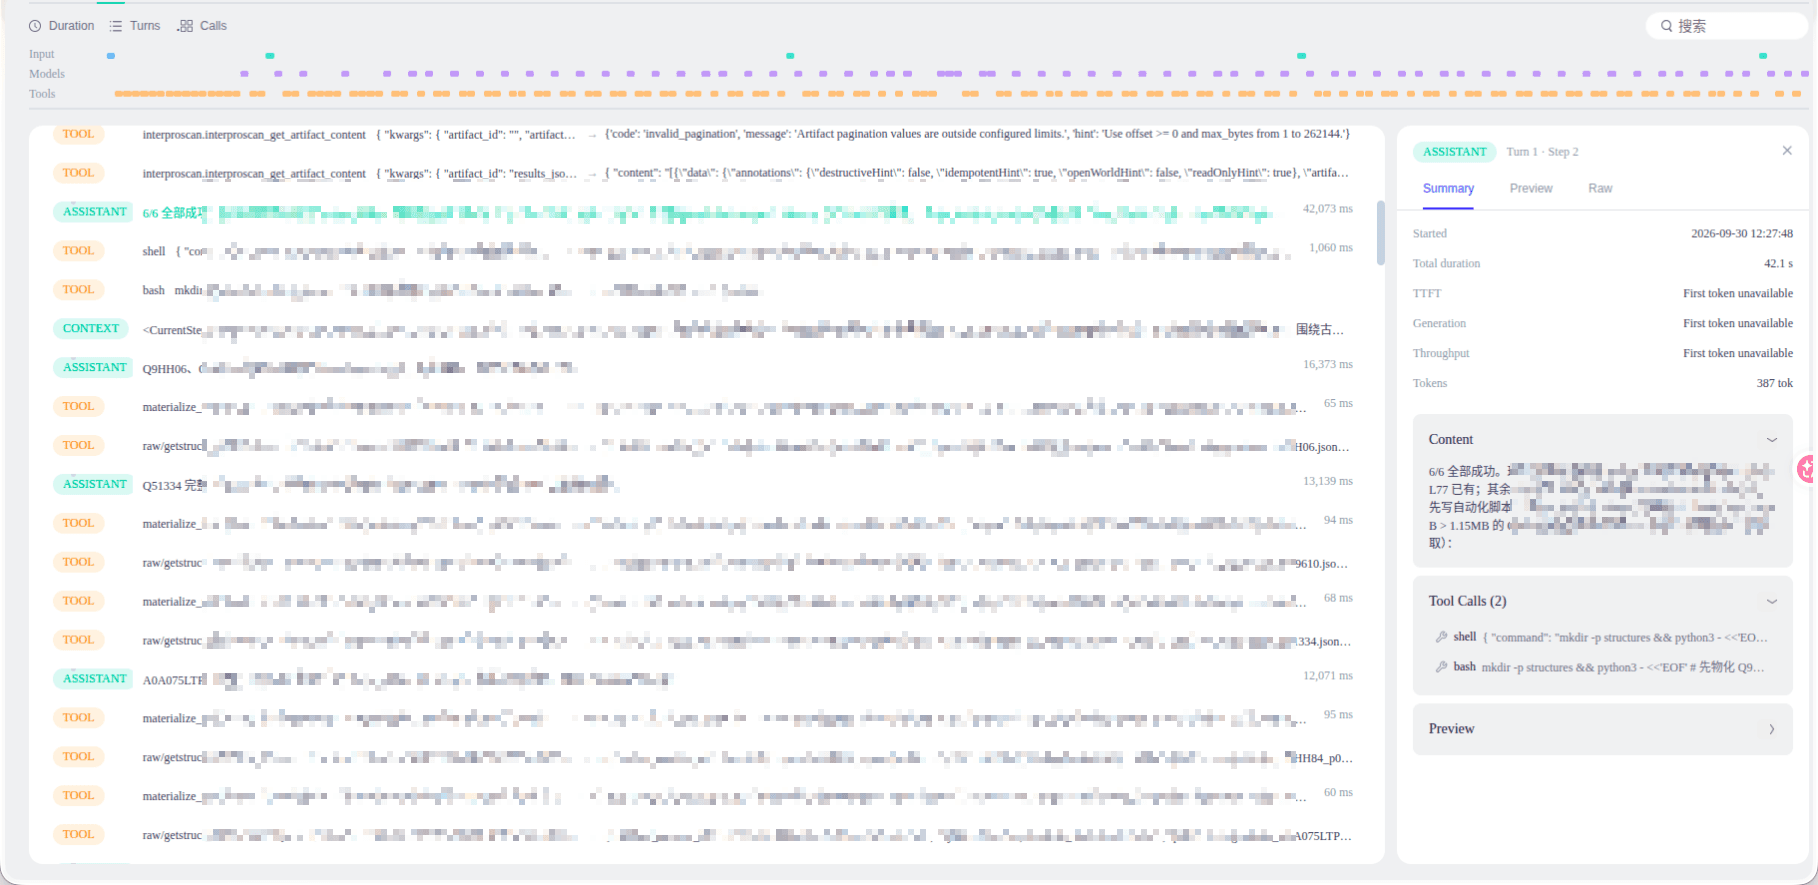
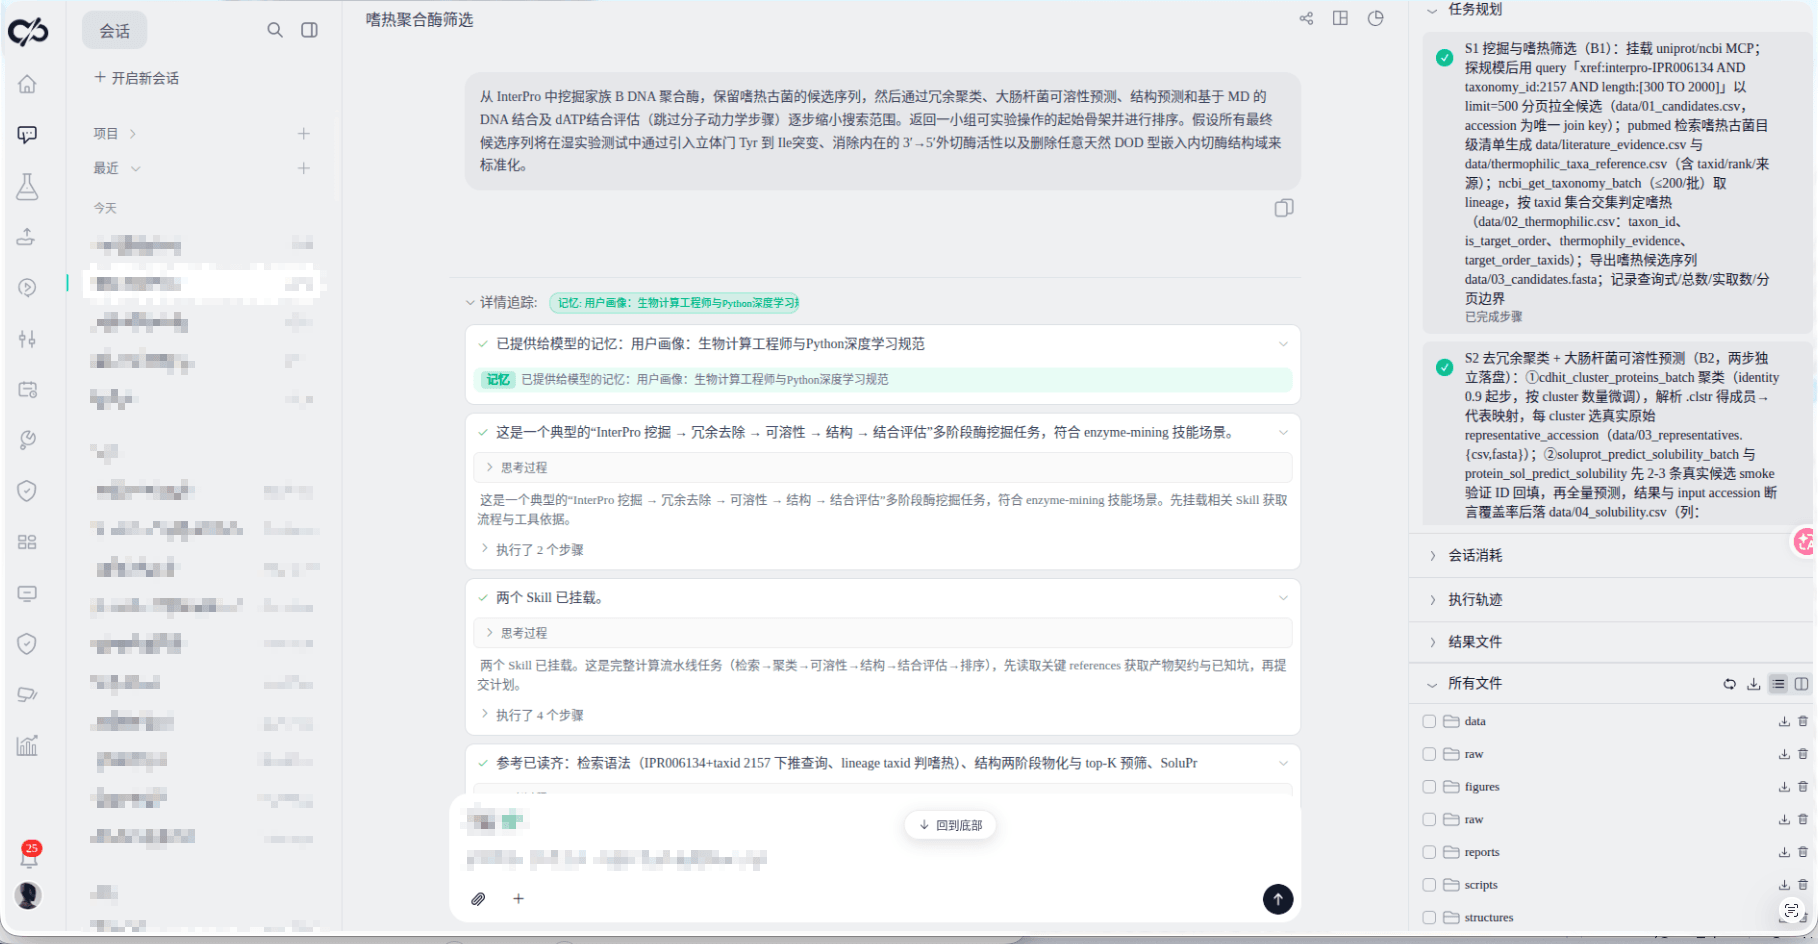
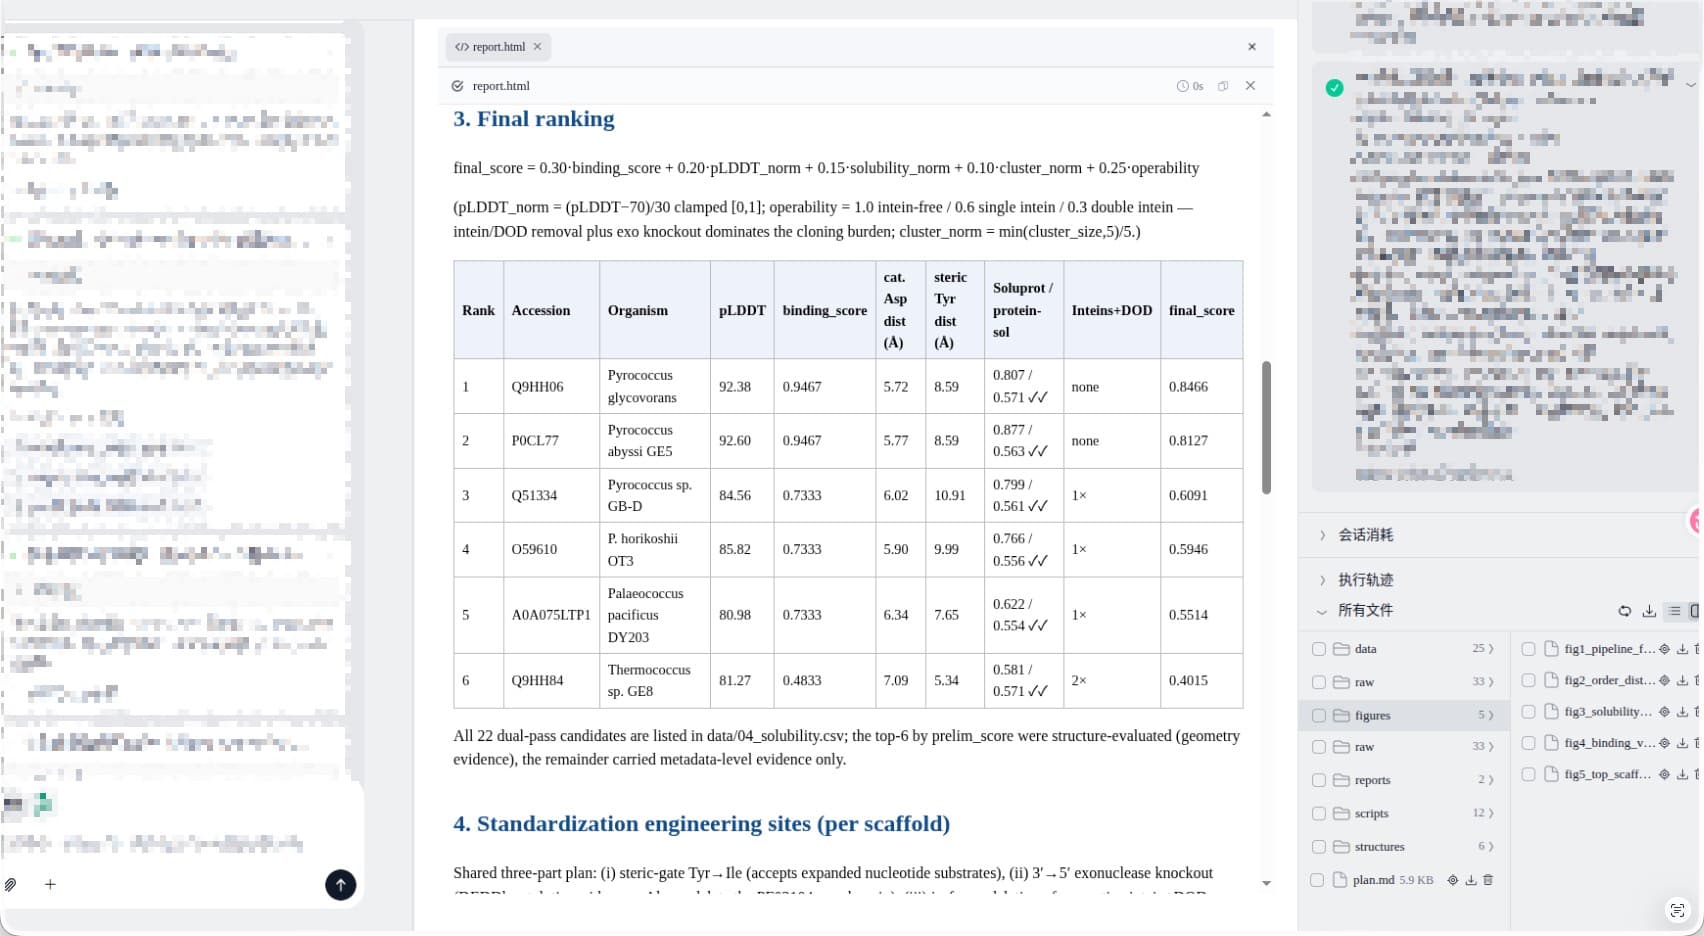
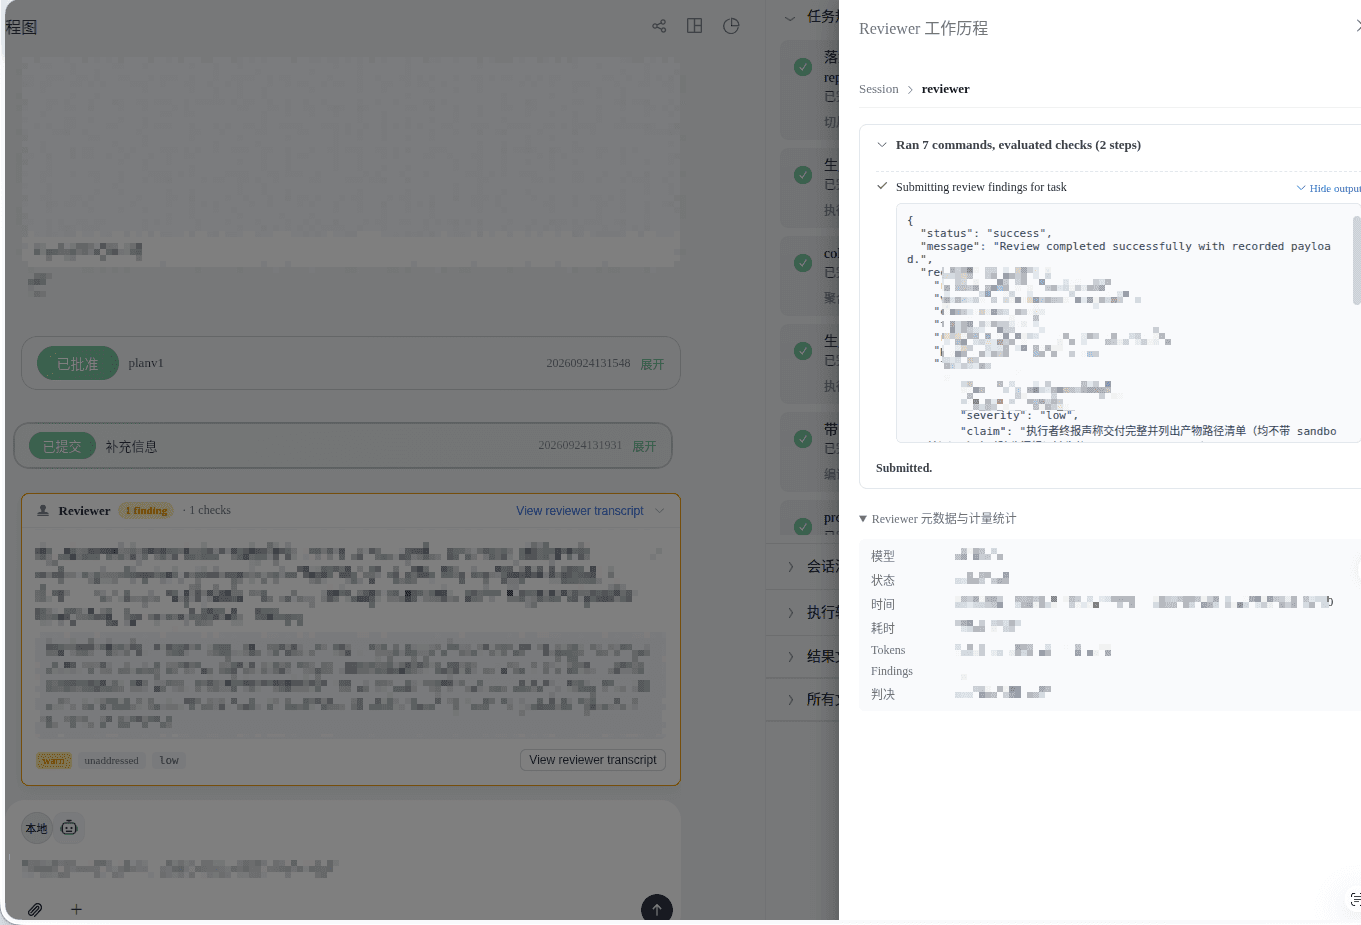
05 / 真实案例:第三方大模型读取 39 MB 证据包
我们用一次真实任务,展示 Scientific Trace 如何支持外部读取与任务交接。将“从嗜热古菌中筛选 B 家族 DNA 聚合酶(PolB)”任务导出的证据包(压缩包,约 39 MB)上传给外部第三方大模型,未提供额外项目背景,只问了一句:“这个压缩包内是什么内容?” 模型思考约 1 分 16 秒后给出了图 5 的回答。
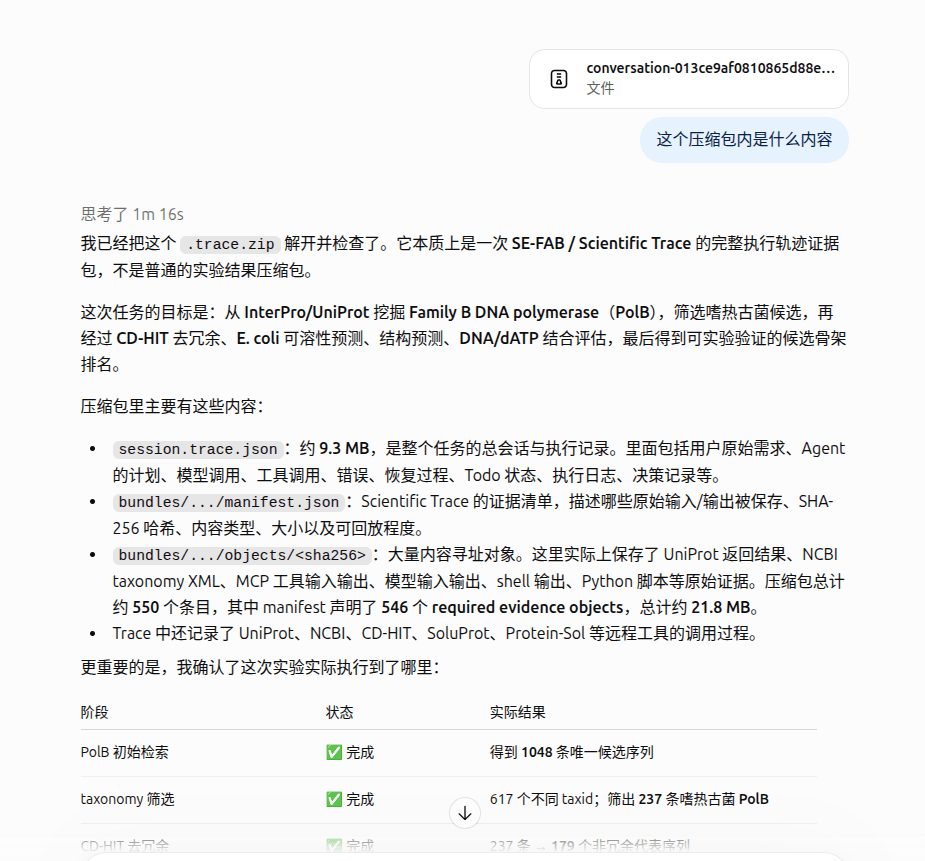
图 5 · 第三方大模型解析证据包:模型将其描述为“完整的执行轨迹证据包”,列出其中的会话记录、证据清单与内容寻址对象,并识别任务记录中显示的执行进展
这次演示表明,在未补充项目背景的情况下,外部模型能够根据导出的记录识别任务目标、计划和部分执行结果。展示范围是对证据包的读取与理解,未包含重新执行计算或复现实验。
06 / 证据成熟度:从看见过程到可复核的证据链
Scientific Trace 的能力沿着科研协作逐层展开:从查看任务过程,到核对结论依据,再到离线交接和经验复用。过程有序、证据可查、决策有归因,生物学家与 Agent 才能在同一份任务档案上继续工作。
以下为 SE-Fab 用于描述自身能力的四级分级框架:
| 级别 | 核心能力 | 判定与核验方式 | SE-Fab 当前状态 |
|---|---|---|---|
| L1 · 可回看与可回放 | 过程可实时查阅,且回放已保存的记录,并展示缺口 | 具备结构化时间轴、已保存的思考记录与事件帧回放能力,页面刷新与重启现场不丢失;未完整保存的环节以完整性标记显式展示 | 已建立(事件流实时渲染、快照恢复与历史记录回放,材料状态与证据缺口随记录标出) |
| L2 · 可复核与可归因 | 结论直达原始证据,保留人机关键抉择 | 判断记录经步骤、调用编号及证据引用,关联工具入参、输出与证据产物;产物以 CAS 哈希保存。人的介入、模型路线取舍与 Reviewer 审查判决均作为区分责任主体的事件记录 | 已建立(独立 Reviewer 证据复核与确定性纠偏,人的介入与复核判决可回放、可追溯责任主体) |
| L3 · 可离线复核与回放 | 脱离在线系统依然能离线校验与回放 | 导出 Evidence Bundle,离线环境下可校验已保存的 SHA-256 CAS 对象与缺口标记,支持脱机回溯已记录的过程与证据关联 | 已建立 |
| L4 · 可继续推理与自进化 | 跨轮次、跨主体读取历史经验底稿接力推进 | 将历史决策、排错记录与实验反馈用于下一轮规划,保留采用依据,并通过后续实验检验调整效果。 | 进行中(Agent 记忆支持已有信息的整理、召回与上下文注入;实验反馈驱动的判断更新与效果验证持续建设) |
这四级阶梯中,有两项能力构成了科学协作的基石:
第一,可回放性(Replay Capability)
科学争议的核查需要能够回溯执行过程。Scientific Trace 按时间顺序重建任务时间线:步骤摘要与思考记录(Thinking)、工具入参和返回、产物变化及复核意见,都能在对应步骤展开查看。生物学家可以回到产生分歧的节点,检查当时使用了什么输入、依据哪些结果作出判断,以及后续为什么调整。
回放重建的是任务执行记录;复现实验则依据这些记录重新开展计算或实验,检验结果。Trace 把当时的输入、参数、产物与决策保留下来,为复现提供可追查的过程底稿。记录标明材料的保存与引用状态,以及写入失败、执行中断等证据缺口,让复核者能够直接定位需要补充的证据。
第二,人类与 Agent 关键抉择的显式归因(Human-Agent Decisions & Handoff)
在严肃科研中,系统应明确记录关键决策的责任主体和依据。Trace 将关键选择与修改依据纳入任务时间线,帮助双方回答:
- 为什么 Agent 放弃了备选算法 B,而选择了算法 A?(模型自主判断及其依据);
- 为什么系统在某一步停下来,请生物学家确认退火温度和循环数?(识别出高风险参数,发起人工确认);
- 人类专家介入时,系统呈现了哪几个候选选项?专家最终裁决选择了哪一条、手动微调了哪个参数?
把这些决策依据与人工确认记录原子化地写进时间线,使得一份成果在交付时不仅能回答“最终结论是什么”,更能清楚交代“谁在什么节点做出了关键裁决、背后的科学依据是什么”。这些记录既帮助生物学家核查方案,也让后续 Agent 理解生物学家的选择及其依据,保持协作过程的连续性。
07 / 结语:让执行留下证据,让证据推动下一轮探索
SE-Fab 的目标,是让 AI 在人类监督下,持续参与科学问题的提出、实验执行与结果验证。在这一实验室架构中,Hardware MCP 为设备能力调用、状态获取与执行反馈提供统一接口;Scientific Trace 则关联设计依据、工具调用与结果,让生物学家能够沿着一个结论,追溯它的产生过程和支撑证据。
这种关联决定了实验经验能否用于下一轮探索。一次活性下降,需要结合具体突变背景和检测条件解释;一次设计判断的修正,需要说明哪些新证据改变了原有认识。当执行过程有据可查,判断变化有因可循,每一轮实验才能为下一轮设计提供可复核的依据。
Scientific Trace 已建立任务留痕、证据关联、独立复核与离线交接,并为经验提炼和召回提供过程依据。生物学家与 Agent 因而拥有可共同查阅的任务底稿,能够解释已有结果、接续研究,并从成功与失败中整理可复用的经验。
让这些记录支持下一轮研究,还需要明确结果的评审标准,并从失败中找到调整方向。涌生智能 CEO 杨梦博士在 2026 年 7 月的专访中指出:“要有效驾驭 AI,我们首先要在工程上为它定义一套严密的 Rubrics——即明确如何验收和评估 AI 生成的结果。”杨梦博士同时强调失败数据的价值,并介绍了将实验分析、文献检索、工具调用及返回结果分层沉淀为知识与实操经验的思路。
在 SE-Fab 中,Scientific Trace 将执行记录、复核意见与判断修正关联起来,为评审和经验积累提供可核查的依据。我们持续完善实验反馈与判断更新的关联,让新结果找到原判断及其依据,把修正后的建议送入下一轮验证,并据此改进评审标准与研究策略。
08 / 我们仍在推进和完善的事
涌生智能的愿景是 Scale Agentic Discovery,让科学发现走向可验证、可复制、可规模化。我们正在连接 AI 的设计与推理、真实实验的执行和结果反馈,让每一轮探索留下的证据成为下一轮设计可以检查和使用的基础。
这项工作需要 AI、软件、实验自动化与生命科学共同推进。如果你也希望解决“如何让一次失败改变下一轮判断”“如何让模型与生物学家接续理解同一项实验”这些问题,欢迎与我们交流,共同建设自进化实验室。
参考资料
- Langfuse. LLM Observability & Tracing (documentation). https://langfuse.com/docs/observability/get-started
- LangChain. LangSmith Observability. https://www.langchain.com/langsmith/observability
- Mitchener L., et al. Kosmos: An AI Scientist for Autonomous Discovery. arXiv:2511.02824. https://arxiv.org/abs/2511.02824
- Kim D., Miao H., Liu S. LEDGER: Claim-to-Evidence Trace Graphs for Auditing LLM Agents. arXiv:2608.18398. https://arxiv.org/abs/2608.18398
- Ren Z., Tan H., Yee J., Hippalgaonkar K. PUDA: An AI-Native Hardware Harness for Self-Driving Laboratories. arXiv:2607.26464. https://arxiv.org/abs/2607.26464
- Rahmanian F., et al. Enabling Modular Autonomous Feedback-Loops in Materials Science through Hierarchical Experimental Laboratory Automation and Orchestration (HELAO). Advanced Materials Interfaces, 2022, DOI: 10.1002/admi.202101987. https://doi.org/10.1002/admi.202101987
- Zhu L., et al. LAP: An Agent-to-Instrument Protocol for Autonomous Science. arXiv:2606.03755. https://arxiv.org/abs/2606.03755
- Rapp J. T., Bremer B. J., Romero P. A. Self-driving laboratories to autonomously navigate the protein fitness landscape. Nature Chemical Engineering, 1, 97-107 (2024). https://www.nature.com/articles/s44286-023-00002-4
- Yin X., Du M., Prince M. H., Cherukara M. J. Artifact-centered Claim-aware Observability for Autonomous Scientific Agents. arXiv:2608.18312. https://arxiv.org/abs/2608.18312
- Souza R., Gueroudji A., DeWitt S., et al. PROV-AGENT: Unified Provenance for Tracking AI Agent Interactions in Agentic Workflows. Proceedings of the 2025 IEEE 21st International Conference on e-Science, 2025. arXiv:2508.02866. https://arxiv.org/abs/2508.02866
- OpenTelemetry. Semantic Conventions for Generative AI (GenAI semantic conventions repository). https://github.com/open-telemetry/semantic-conventions-genai
- Workflow Run RO-Crate. Research Object. https://www.researchobject.org/workflow-run-crate/